Протестировали бесплатную локальную модель для генерации изображений Qwen-Image-2.1 от Alibaba, которая может создавать и редактировать изображения.
Qwen-Image-2.1 — компактная модель с возможностью локального запуска. Она умеет генерировать и редактировать изображения по текстовым запросам, поддерживает прозрачность и одновременную работу с несколькими референсами.
- Полная BF16: https://github.com/QwenLM/Qwen-Image-2.1
- Сжатая (квантованная) Q8 https://huggingface.co/unsloth/Qwen-Image-2.1-GGUF/blob/main/qwen-image-2.1-Q8_0.gguf
- Сжатая (квантованная) Q4: https://huggingface.co/unsloth/Qwen-Image-2.1-GGUF/blob/main/qwen-image-2.1-Q4_K_M.gguf
- Онлайн демо: https://huggingface.co/spaces/Qwen/Qwen-Image-2.1 (часто перегружено)
Квантованная модель — модель, веса которой хранятся с меньшей числовой точностью. Она занимает меньше места и обычно требует меньше памяти, но может немного терять в качестве.
Мы тестировали 2 квантованные версии на 2х разных железах:
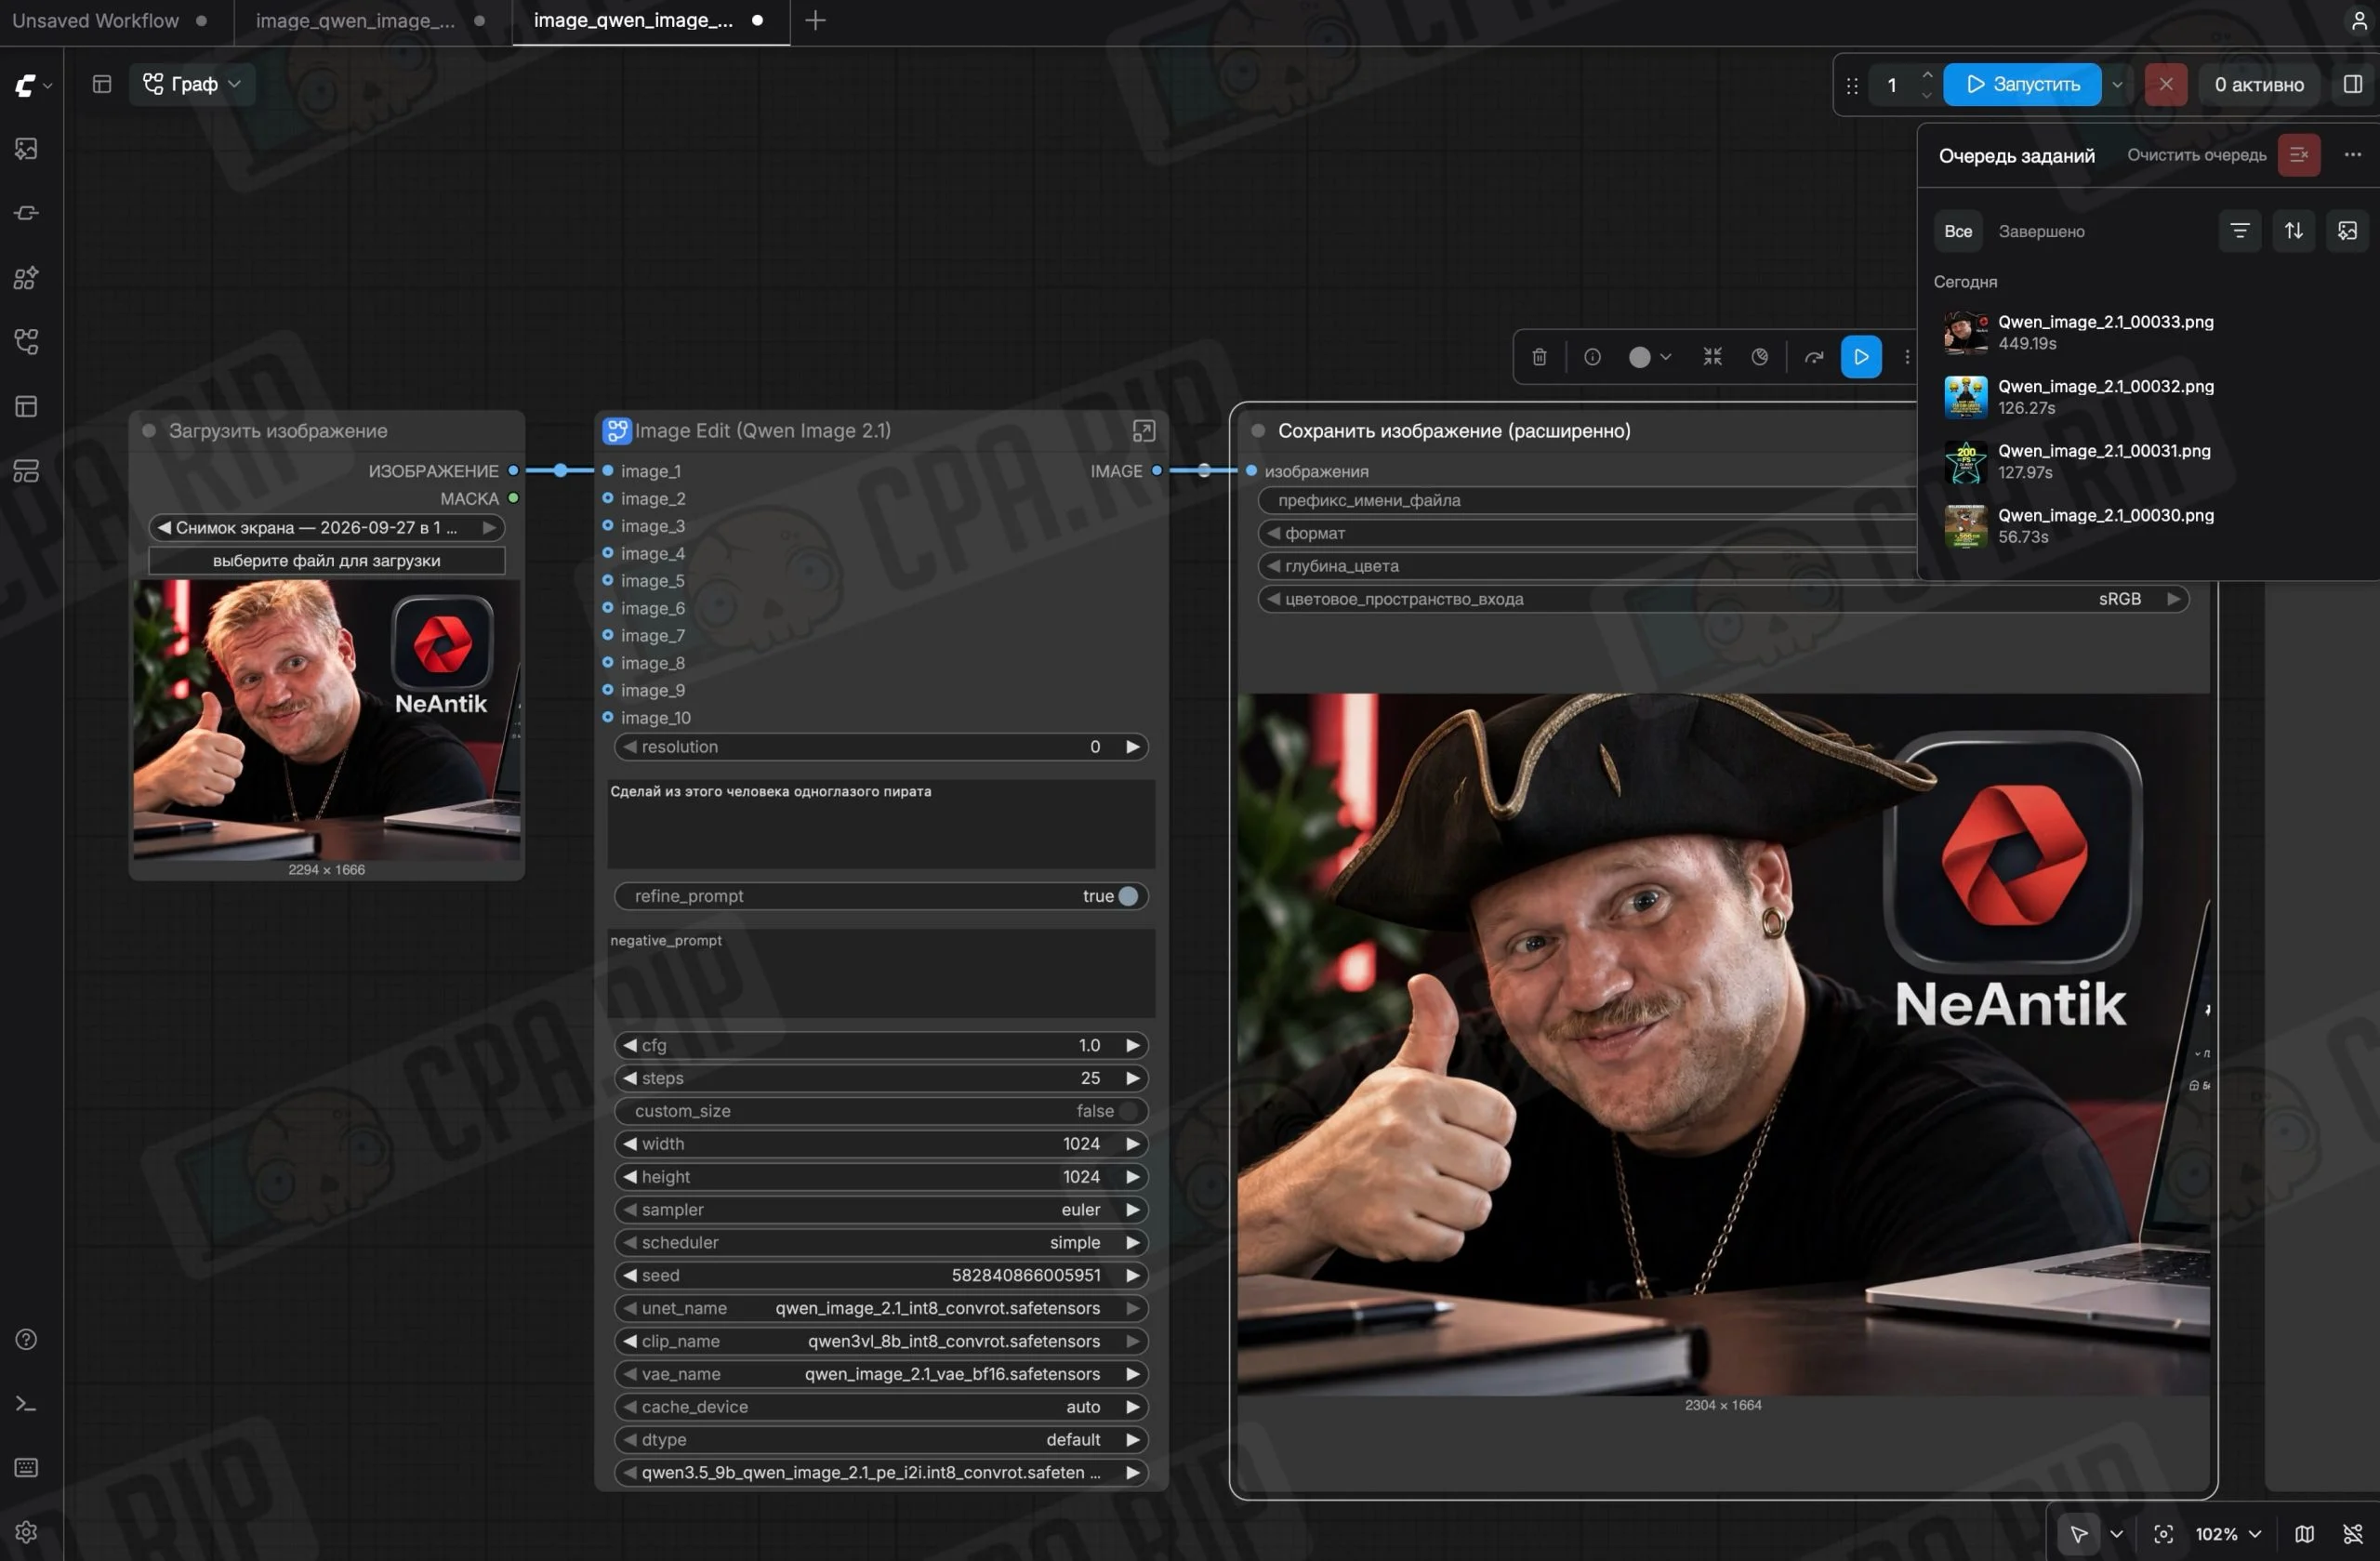
Qwen-Image-2.1 на DGX Spark в ComfyUI 0.37.0. Установлены следующие компоненты:
- генератор на 7B в квантизации Q8_0;
- Текстовый энкодер Qwen3-VL 8B — INT8 ConvRot от Comfy-Org.
- VAE в BF16;
- две модели улучшения промптов на базе Qwen3.5-VL 9B: для генерации и редактирования.
- Всего около 36 ГБ на диске.
Qwen-Image-2.1 на Mac с M3 Pro и 18 ГБ памяти через stable-diffusion.cpp, сборка master-920-2f88688, с ускорением Metal.
- генератор на 7B в квантизации Q4_K_M;
- текстовый энкодер Qwen3-VL 8B в квантизации UD-Q4_K_XL;
- отдельный модуль зрения mmproj в F16 для работы с референсами;
- VAE в BF16.
- Модели улучшения промптов не устанавливались.
- Всего около 11,2 ГБ весов на диске.
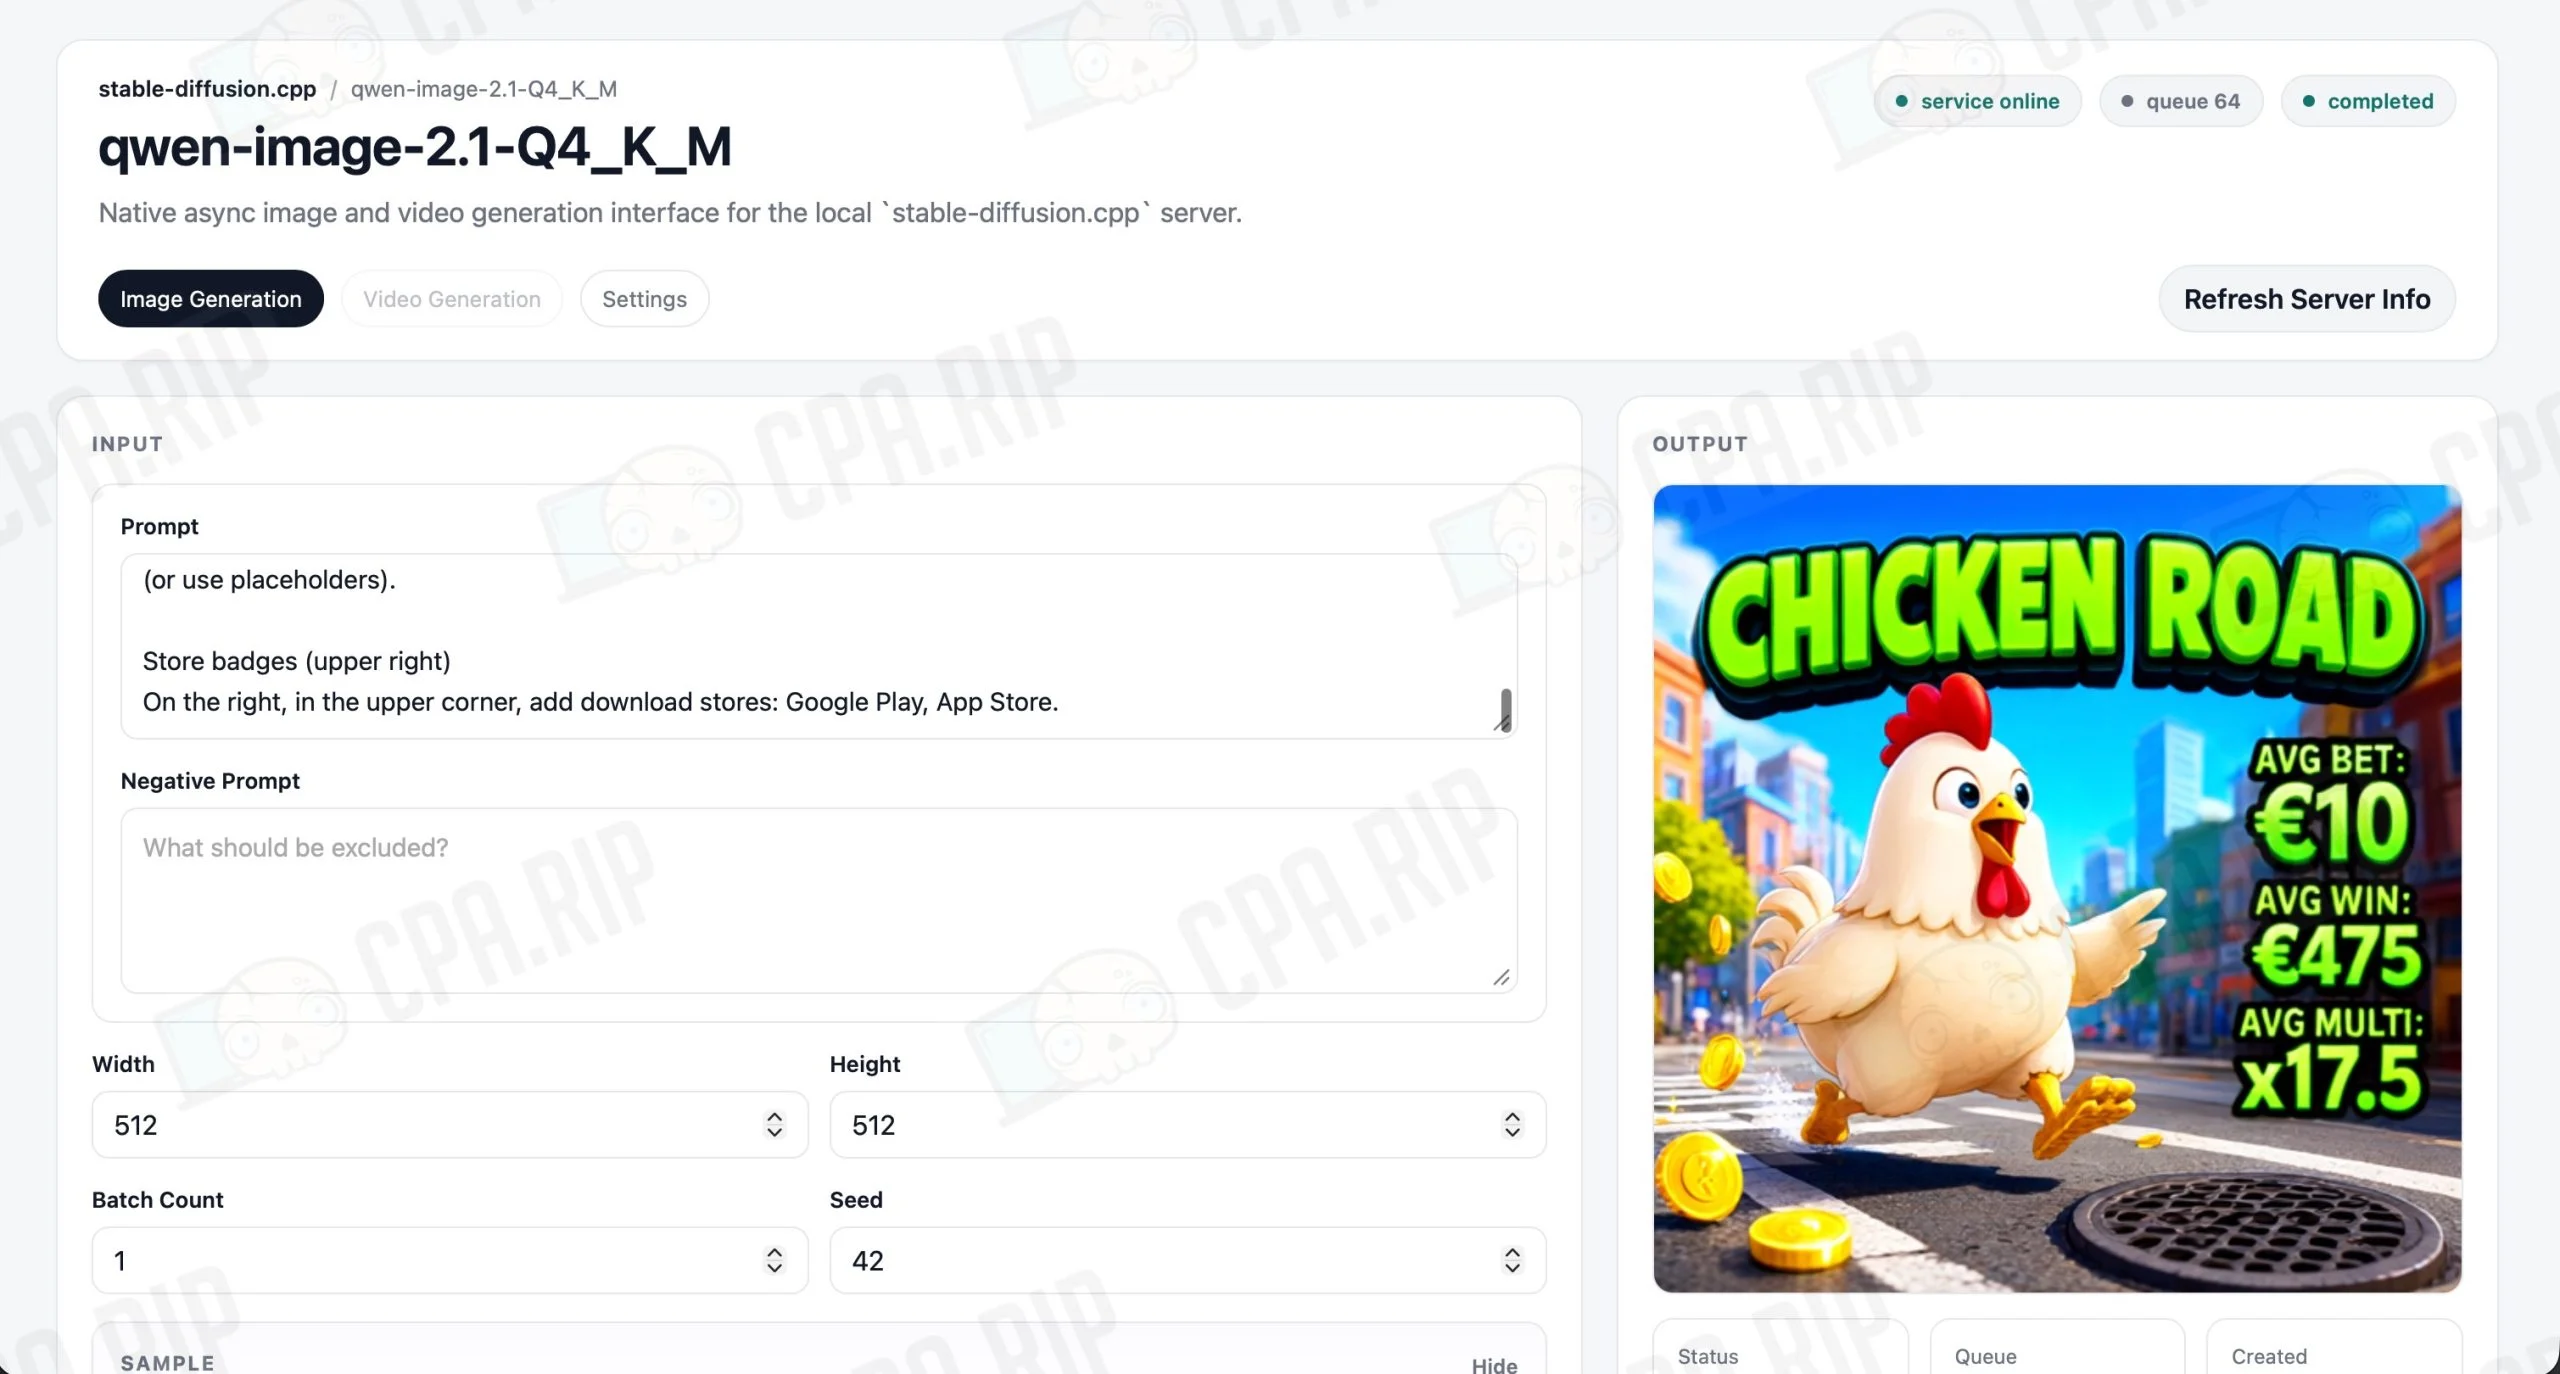
Протестированные нами модели не имели цензуры — все запросы выполнились без отказа!
Результаты генерации
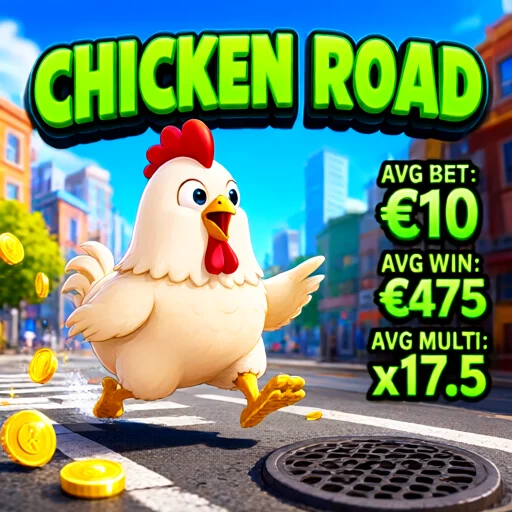
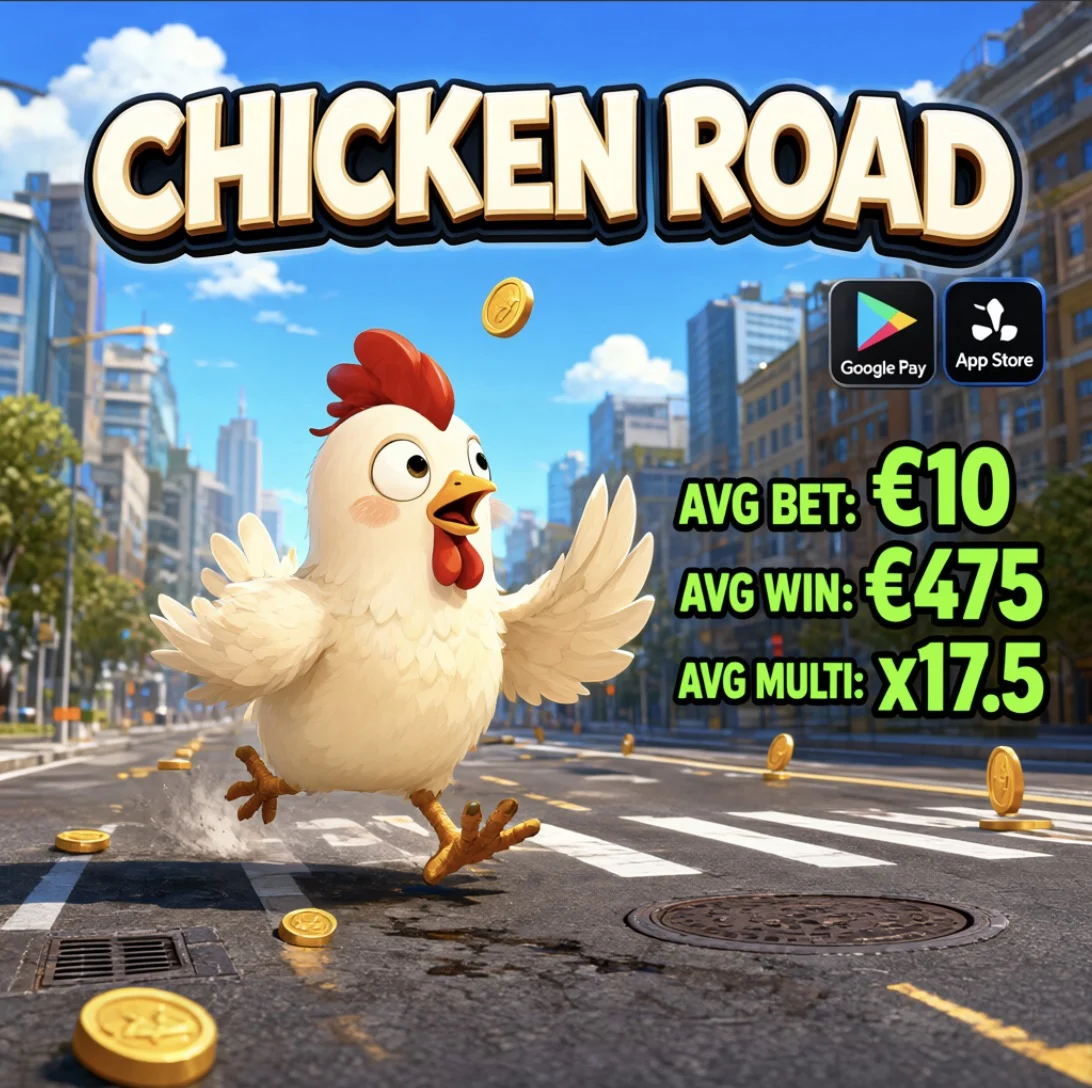
Использовали проверенный промпт из статьи https://cpa.rip/prompts/ai-prompts-igaming/.
Сжатая Q4 на Macbook Pro M3 pro 18Gb, размер 512×512, время генерации 5 минут, 47 секунд:
Qwen-Image-2.1 Q8 на DGX Spark, размер 1092×1088, время генерации 10 секунд:
Загрузили креатив в LLM и попросили составить описание в формате JSON. По этому описанию Qwen-Image-2.1 сгенерировала похожую картинку:
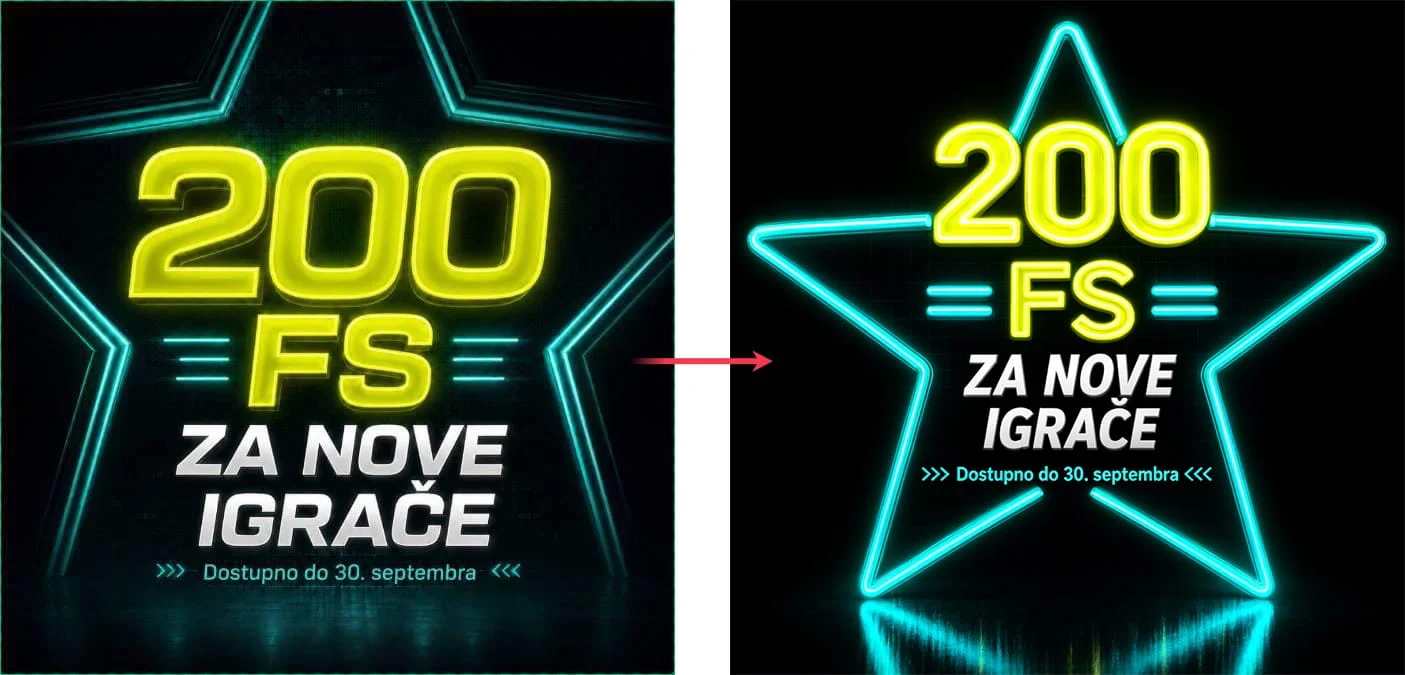
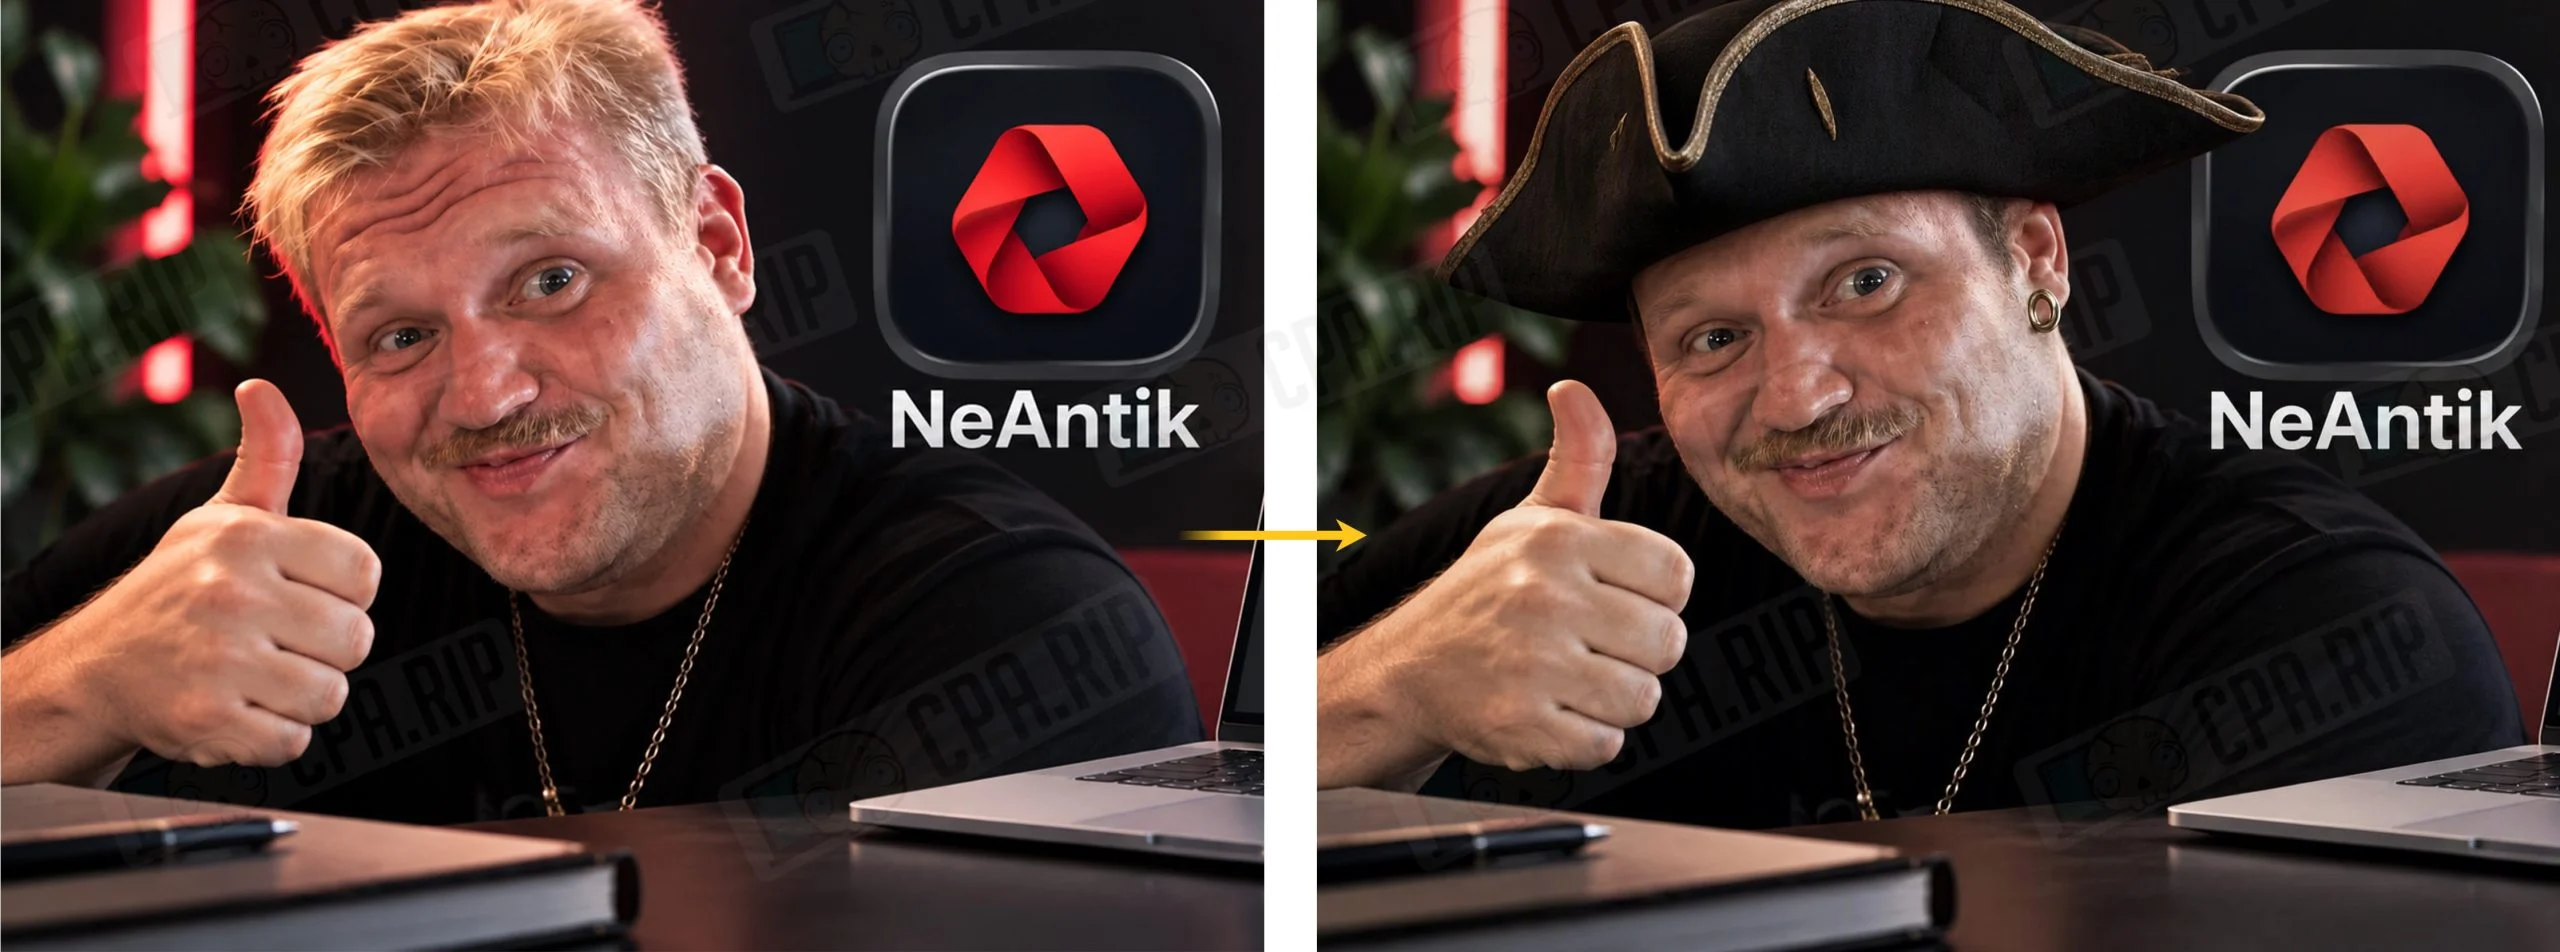
Тест редактирования готового референса на Q8:
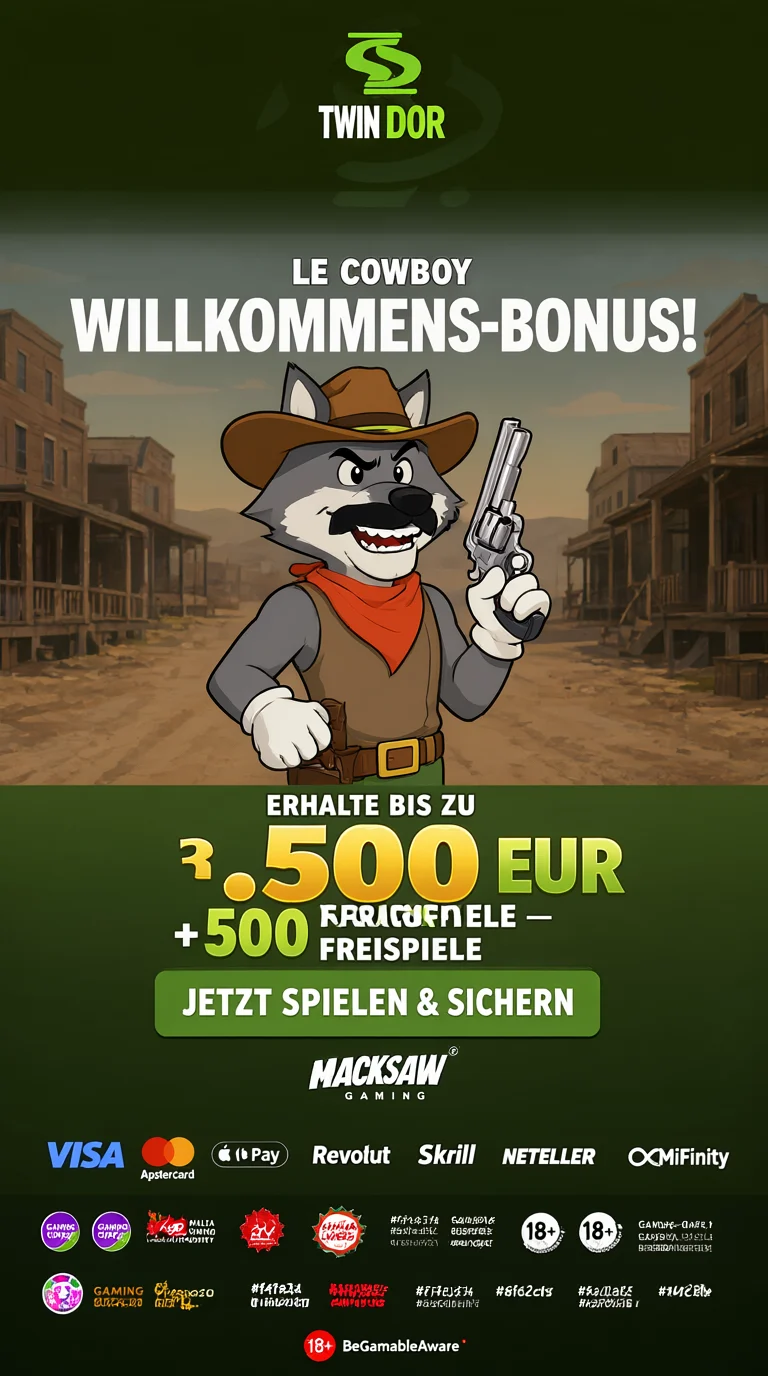
При генерации изображений с большим количеством текста могут возникать ошибки и артефакты:
Доступные режимы Qwen-Image-2.1
Qwen-Image-2.1 объединяет генерацию и редактирование в одной модели. Доступны следующие режимы:
- Генерация по тексту — создание изображения с нуля.
- Редактирование изображения — изменение загруженной картинки текстовой командой, например, замена фона, цвета одежды или предмета.
- Работа с несколькими референсами — объединение объектов, персонажей и деталей из разных референсы. Модель поддерживает до 10 изображений.
- Генерация и редактирование с прозрачностью — создание объектов на прозрачном фоне и изменение существующих RGBA-изображений.
- Извлечение объекта — выделение человека или предмета с фотографии с удалением окружающего фона.
- Локальные правки — изменение выбранной области, обозначенной кругом, нарисованной пометкой или отдельной маской.
Установка с помощью Codex/Claude Code
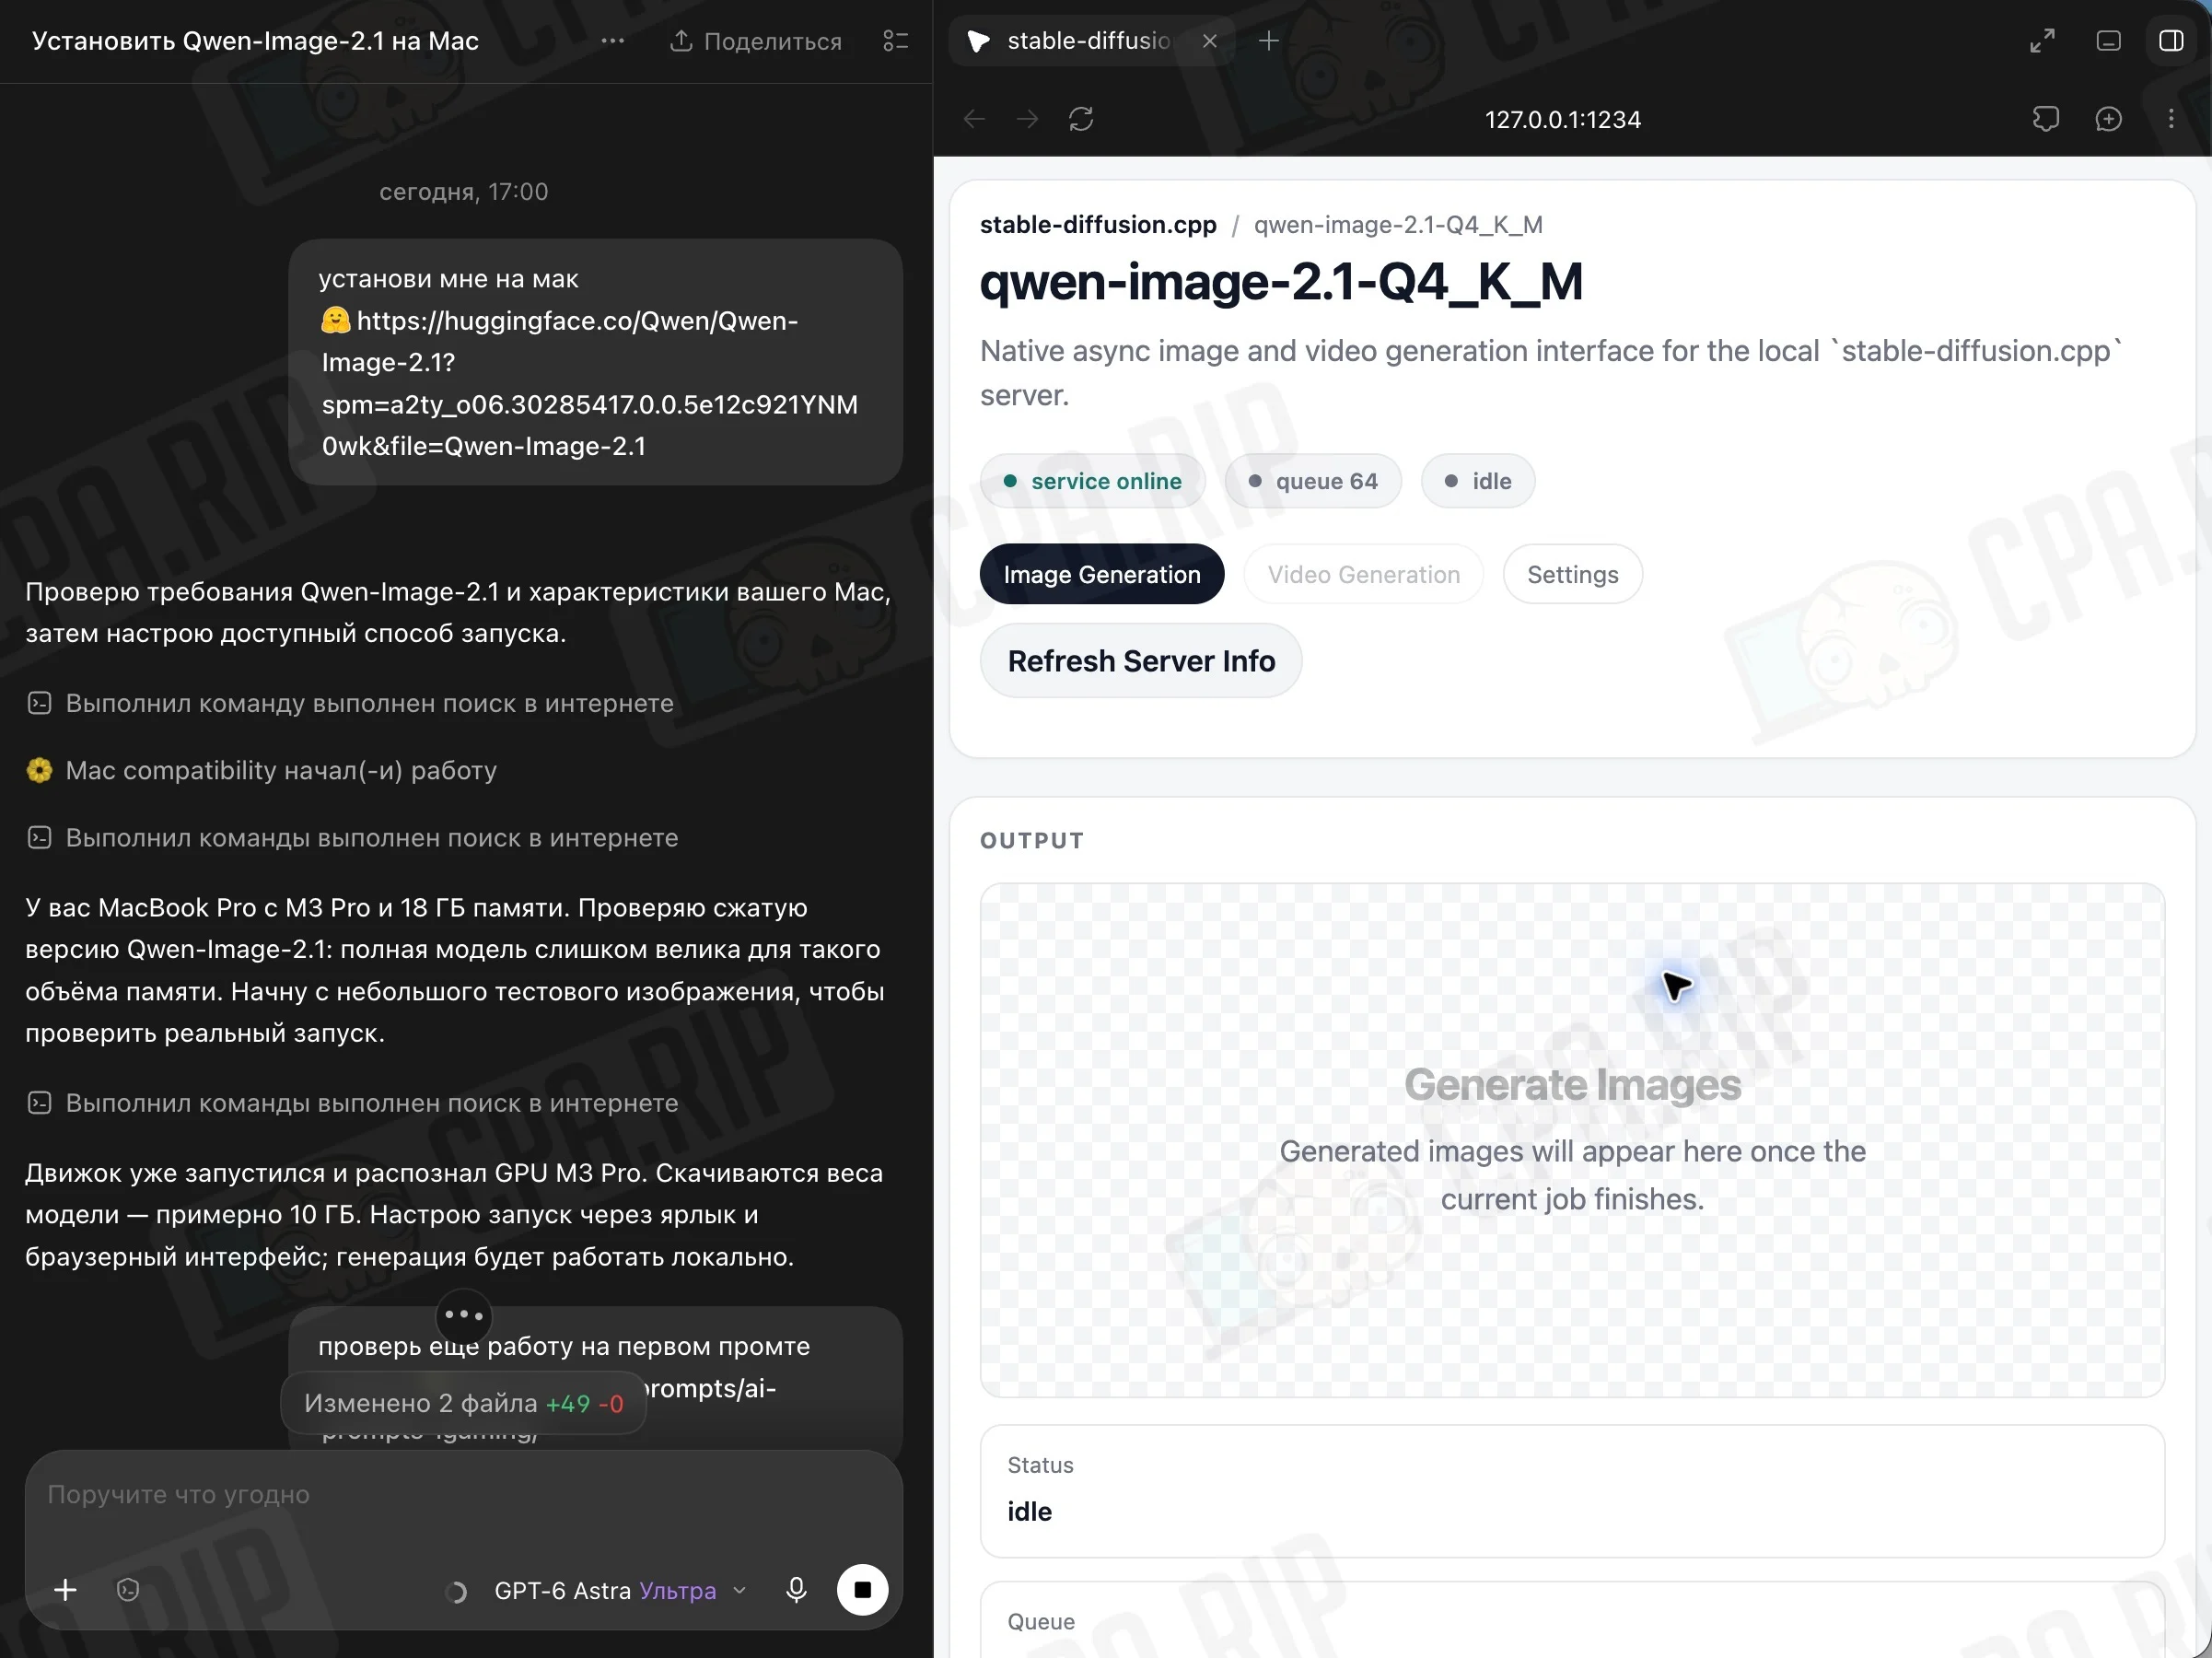
Самый простой способ установки локальной Qwen-Image-2.1 дать команду LLM и она все установит, настроит и проверит. Пример команды:
Установи мне на мак https://huggingface.co/Qwen/Qwen-Image-2.1?spm=a2ty_o06.30285417.0.0.5e12c921YNM0wk&file=Qwen-Image-2.1
При этом Codex сам подобрал сжатую версию Q4_K_M, которая будет работать на нашем железе, при необходимости можно указать точную модель: